

Debian hat am 29. September ein Sicherheitsupdate für den Linux-Kernel veröffentlicht. Was zunächst nach einem gewöhnlichen Debian Security Advisory klingt, fällt durch eine ungewöhnliche Zahl auf: DSA-6528-1 führt insgesamt 1313 CVE-Kennungen auf. Die Liste der damit behobenen oder für Debian relevanten Schwachstellen ist so lang, dass sie bei LWN den größten Teil der Meldung einnimmt.
1313 Sicherheitslücken in einem einzigen Update? Die Zahl wirkt alarmierend, sagt für sich genommen aber erstaunlich wenig über die Sicherheit des Linux-Kernels aus. Vielmehr zeigt sie, wie grundlegend sich der Umgang mit CVEs im Kernel in den vergangenen Jahren verändert hat. Sie wirft zudem die Frage auf, wie lange Entwickler, Distributionen und Administratoren mit immer weiter steigenden Zahlen sinnvoll umgehen können.
Im Zweifelsfall lieber eine CVE zu viel
Seit Anfang 2024 besitzt das Linux-Kernel-Projekt den Status einer CVE Numbering Authority (CNA) und kann damit selbst CVE-Kennungen vergeben. Dahinter steht nicht zuletzt die Unzufriedenheit der Kernel-Entwickler mit der früheren Praxis, bei der externe Organisationen teilweise CVEs für Kernel-Probleme vergaben, ohne deren Bedeutung oder betroffene Versionen zuverlässig einschätzen zu können.
Das Kernel-Team verfolgt seitdem einen ausgesprochen vorsichtigen Ansatz. Im Rahmen des normalen Stable-Prozesses werden Änderungen identifiziert, die möglicherweise sicherheitsrelevant sind, und dafür automatisiert CVE-Nummern vergeben. Die Kernel-Dokumentation erklärt die daraus resultierenden hohen Zahlen bemerkenswert offen: Aufgrund der zentralen Stellung des Kernels könne prinzipiell fast jeder Fehler zur Beeinträchtigung der Systemsicherheit ausgenutzt werden. Da dies zum Zeitpunkt der Fehlerbehebung häufig noch gar nicht sicher beurteilt werden könne, vergebe das CVE-Team im Zweifelsfall lieber eine Kennung.
Eine CVE steht damit beim Linux-Kernel längst nicht mehr zwangsläufig für eine bekannte und praktisch ausnutzbare Sicherheitslücke. Häufig handelt es sich um einen normalen Bugfix, bei dem eine sicherheitsrelevante Auswirkung lediglich nicht ausgeschlossen werden kann.
Auch die Zahl 1313 bedeutet folglich nicht, dass Debian gerade mehr als tausend akut ausnutzbare Schwachstellen entdeckt und behoben hätte. Hinzu kommt, dass ein installiertes System nur einen Bruchteil des enormen Kernel-Quellcodes tatsächlich nutzt. Das Kernel-Projekt weist deshalb selbst darauf hin, dass zahlreiche veröffentlichte CVEs für ein konkretes System überhaupt keine Relevanz besitzen.
Das Problem verschiebt sich
Für die Kernel-Entwickler selbst bedeutet die steigende Zahl der CVEs daher nicht automatisch einen entsprechenden zusätzlichen Arbeitsaufwand. Viele der zugrunde liegenden Fehler wären ohnehin gefunden, korrigiert, überprüft und gegebenenfalls in die unterstützten Stable-Kernel zurückportiert worden. Die CVE-Vergabe baut auf diesem Prozess auf und erfolgt erst, nachdem ein Fix verfügbar ist und in einen Stable-Kernel aufgenommen wurde.
Mehrarbeit für Distributoren und Unternehmen
Damit verschiebt sich das Problem allerdings. Distributionen wie Debian müssen nachvollziehen, welche dieser Änderungen ihre Kernel betreffen. Hersteller von Sicherheitswerkzeugen müssen die Informationen aufbereiten. Unternehmen wiederum müssen entscheiden, welche CVEs für ihre Systeme tatsächlich relevant sind. Compliance-Vorgaben und Vulnerability-Scanner erzeugen aus jeder einzelnen Kennung möglicherweise ein Ticket, das bewertet, dokumentiert und geschlossen werden muss.
Bei einigen Dutzend CVEs lässt sich ein solcher Prozess noch weitgehend manuell bewältigen. Bei mehr als tausend Kennungen aus einem einzigen Kernel-Update wird offensichtlich, dass dieses Modell nicht beliebig skaliert.
Die reine Anzahl einer CVE verliert dabei zunehmend ihre Signalwirkung. Ursprünglich soll eine CVE eine öffentlich bekannte Schwachstelle eindeutig identifizierbar machen. Wenn jedoch ein großer Teil der normalen Kernel-Bugfixes vorsorglich mit einer solchen Kennung versehen wird, bedeutet »hat eine CVE« kaum noch automatisch »benötigt besondere Aufmerksamkeit«.
Das »new normal«
Parallel dazu verändert sich derzeit auch die Geschwindigkeit, mit der Fehler überhaupt gefunden werden. Bei der Veröffentlichung von Linux 7.0 im April bemerkte Linus Torvalds eine ungewöhnlich hohe Zahl kleiner Korrekturen während der Entwicklung. Als mögliche Ursache nannte er den zunehmenden Einsatz von KI-Werkzeugen, die immer weitere Sonderfälle im Quellcode aufspürten. Dies könne zumindest für einige Zeit das »new normal« werden.
Dabei blieb es nicht. Bereits bei Linux 7.1 stellte Torvalds fest, dass die höhere Zahl der Änderungen offenbar kein einmaliger Ausreißer gewesen sei, sondern tatsächlich zum neuen Normalzustand werde. Bei Linux 7.2 sprach er erneut von einer höheren Änderungsrate und stellte während des Release-Candidate-Zyklus ausdrücklich fest, dass viele der zahlreichen kleinen Fixes auf Reviews durch verschiedene KI-Werkzeuge zurückgingen. Selbst bei der finalen Freigabe von Linux 7.2 spielte Torvalds auf das inzwischen etablierte »new normal« an: Würde er Releases allein wegen der Zahl der späten Fixes verschieben, könne man womöglich gar keinen Kernel mehr veröffentlichen.
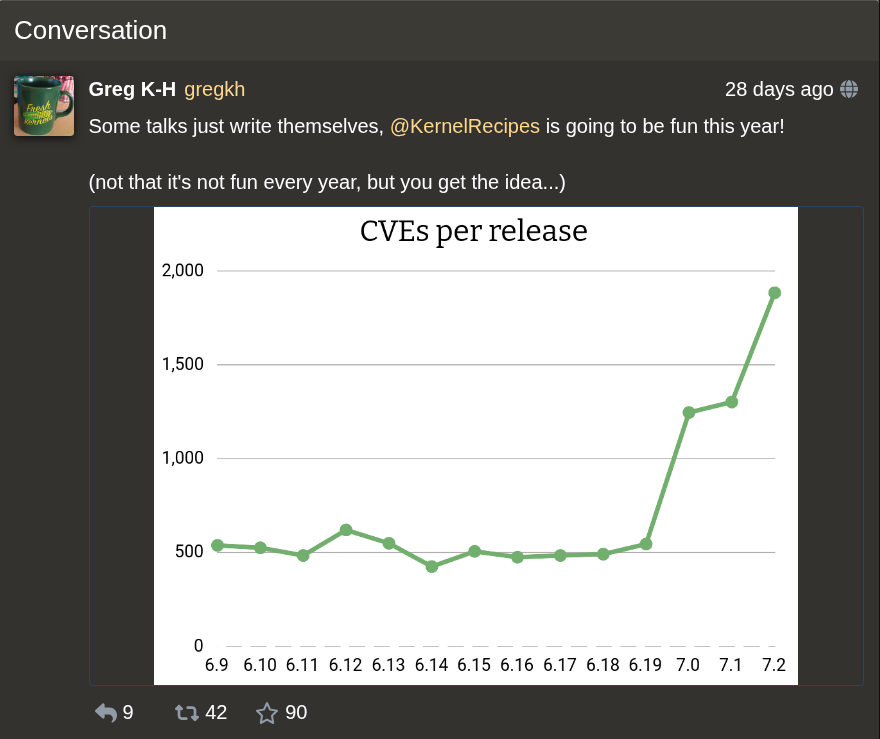
Damit treffen derzeit zwei Entwicklungen aufeinander. Automatisierte Analysewerkzeuge finden immer mehr Fehler und ungewöhnliche corner cases im Kernel. Gleichzeitig versieht der neue CVE-Prozess einen großen Teil potenziell sicherheitsrelevanter Fehlerbehebungen mit einer eigenen Kennung. Mehr gefundene Fehler führen zu mehr Fixes und mehr Fixes wiederum zu mehr CVEs.
Vom »new normal« zum »newer normal«?
Das muss nicht bedeuten, dass der Linux-Kernel unsicherer wird. Im Gegenteil: Eine wachsende CVE-Zahl kann unter diesen Bedingungen sogar daraus entstehen, dass Fehler systematischer gefunden und schneller beseitigt werden. Ein Vergleich nach dem Muster »Linux hatte vor drei Jahren deutlich weniger CVEs und ist deshalb heute unsicherer« hinkt deshalb heute gewaltig.
Die spannendere Frage lautet: Wie lange können Entwickler und Maintainer mit diesem Wachstum Schritt halten? KI-gestützte Werkzeuge können nahezu beliebig viele weitere Stellen untersuchen und Verdachtsfälle produzieren. Ein Patch muss aber weiterhin verstanden, überprüft und daraufhin beurteilt werden, ob er tatsächlich korrekt ist und nicht an anderer Stelle neue Regressionen verursacht.
Engpass in Sicht
Hier liegt vermutlich der eigentliche Engpass der kommenden Jahre. Nicht das Erzeugen weiterer CVE-Nummern dürfte zum Problem werden, sondern die begrenzte Zeit erfahrener Maintainer für Review, Stable-Backports und Regressionstests.
Gleichzeitig werden auch Anwender und Unternehmen nicht dauerhaft Tausende Kernel-CVEs einzeln bewerten können. Die Konsequenz dürfte eine stärkere Automatisierung auf der anderen Seite sein: Werkzeuge müssen lernen, anhand von Kernel-Version, Konfiguration, Architektur und tatsächlich verwendetem Code festzustellen, welche Schwachstellen auf einem konkreten System überhaupt relevant sein können. Das sollte bei der heutigen rasanten Entwicklung bei der KI kein Problem sein.
Das Kernel-Projekt empfiehlt ohnehin seit Langem einen anderen Umgang. Statt einzelne vermeintlich wichtige Sicherheitspatches aus einem Stable-Release herauszupicken, sollen Anwender möglichst den gesamten aktuellen Stable-Kernel übernehmen. Schließlich besteht die vollständige Lösung eines Problems nicht immer aus einem einzelnen Commit, sondern kann sich erst aus mehreren aufeinander aufbauenden Änderungen ergeben. Selbst Fixes ohne CVE-Kennung könnten sicherheitsrelevant sein.
Veränderter Maßstab
Die 1313 CVEs des aktuellen Debian-Updates sind deshalb weniger ein Beleg für einen außergewöhnlich unsicheren Kernel als ein Hinweis darauf, dass sich der Maßstab verändert hat. Das bisherige »new normal« aus immer mehr kleinen, teilweise automatisiert gefundenen Fehlerkorrekturen trifft auf ein CVE-System, das diese Entwicklung zunehmend sichtbar macht.
Sollten KI-Werkzeuge ihre Fähigkeiten bei der statischen Analyse und beim Code-Review weiter verbessern, könnten vierstellige CVE-Zahlen daher keineswegs ein einmaliger Ausreißer bleiben. Dann würde sich allerdings auch die Bedeutung einer solchen Zahl endgültig ändern. Die relevante Frage wäre nicht mehr, wie viele CVEs ein Kernel besitzt, sondern welche davon auf einem konkreten System tatsächlich eine ausnutzbare Schwachstelle darstellen. Das »new normal« könnte damit schon bald ein »newer normal« benötigen.
